只做已经做出来的事,不做宣传话术。
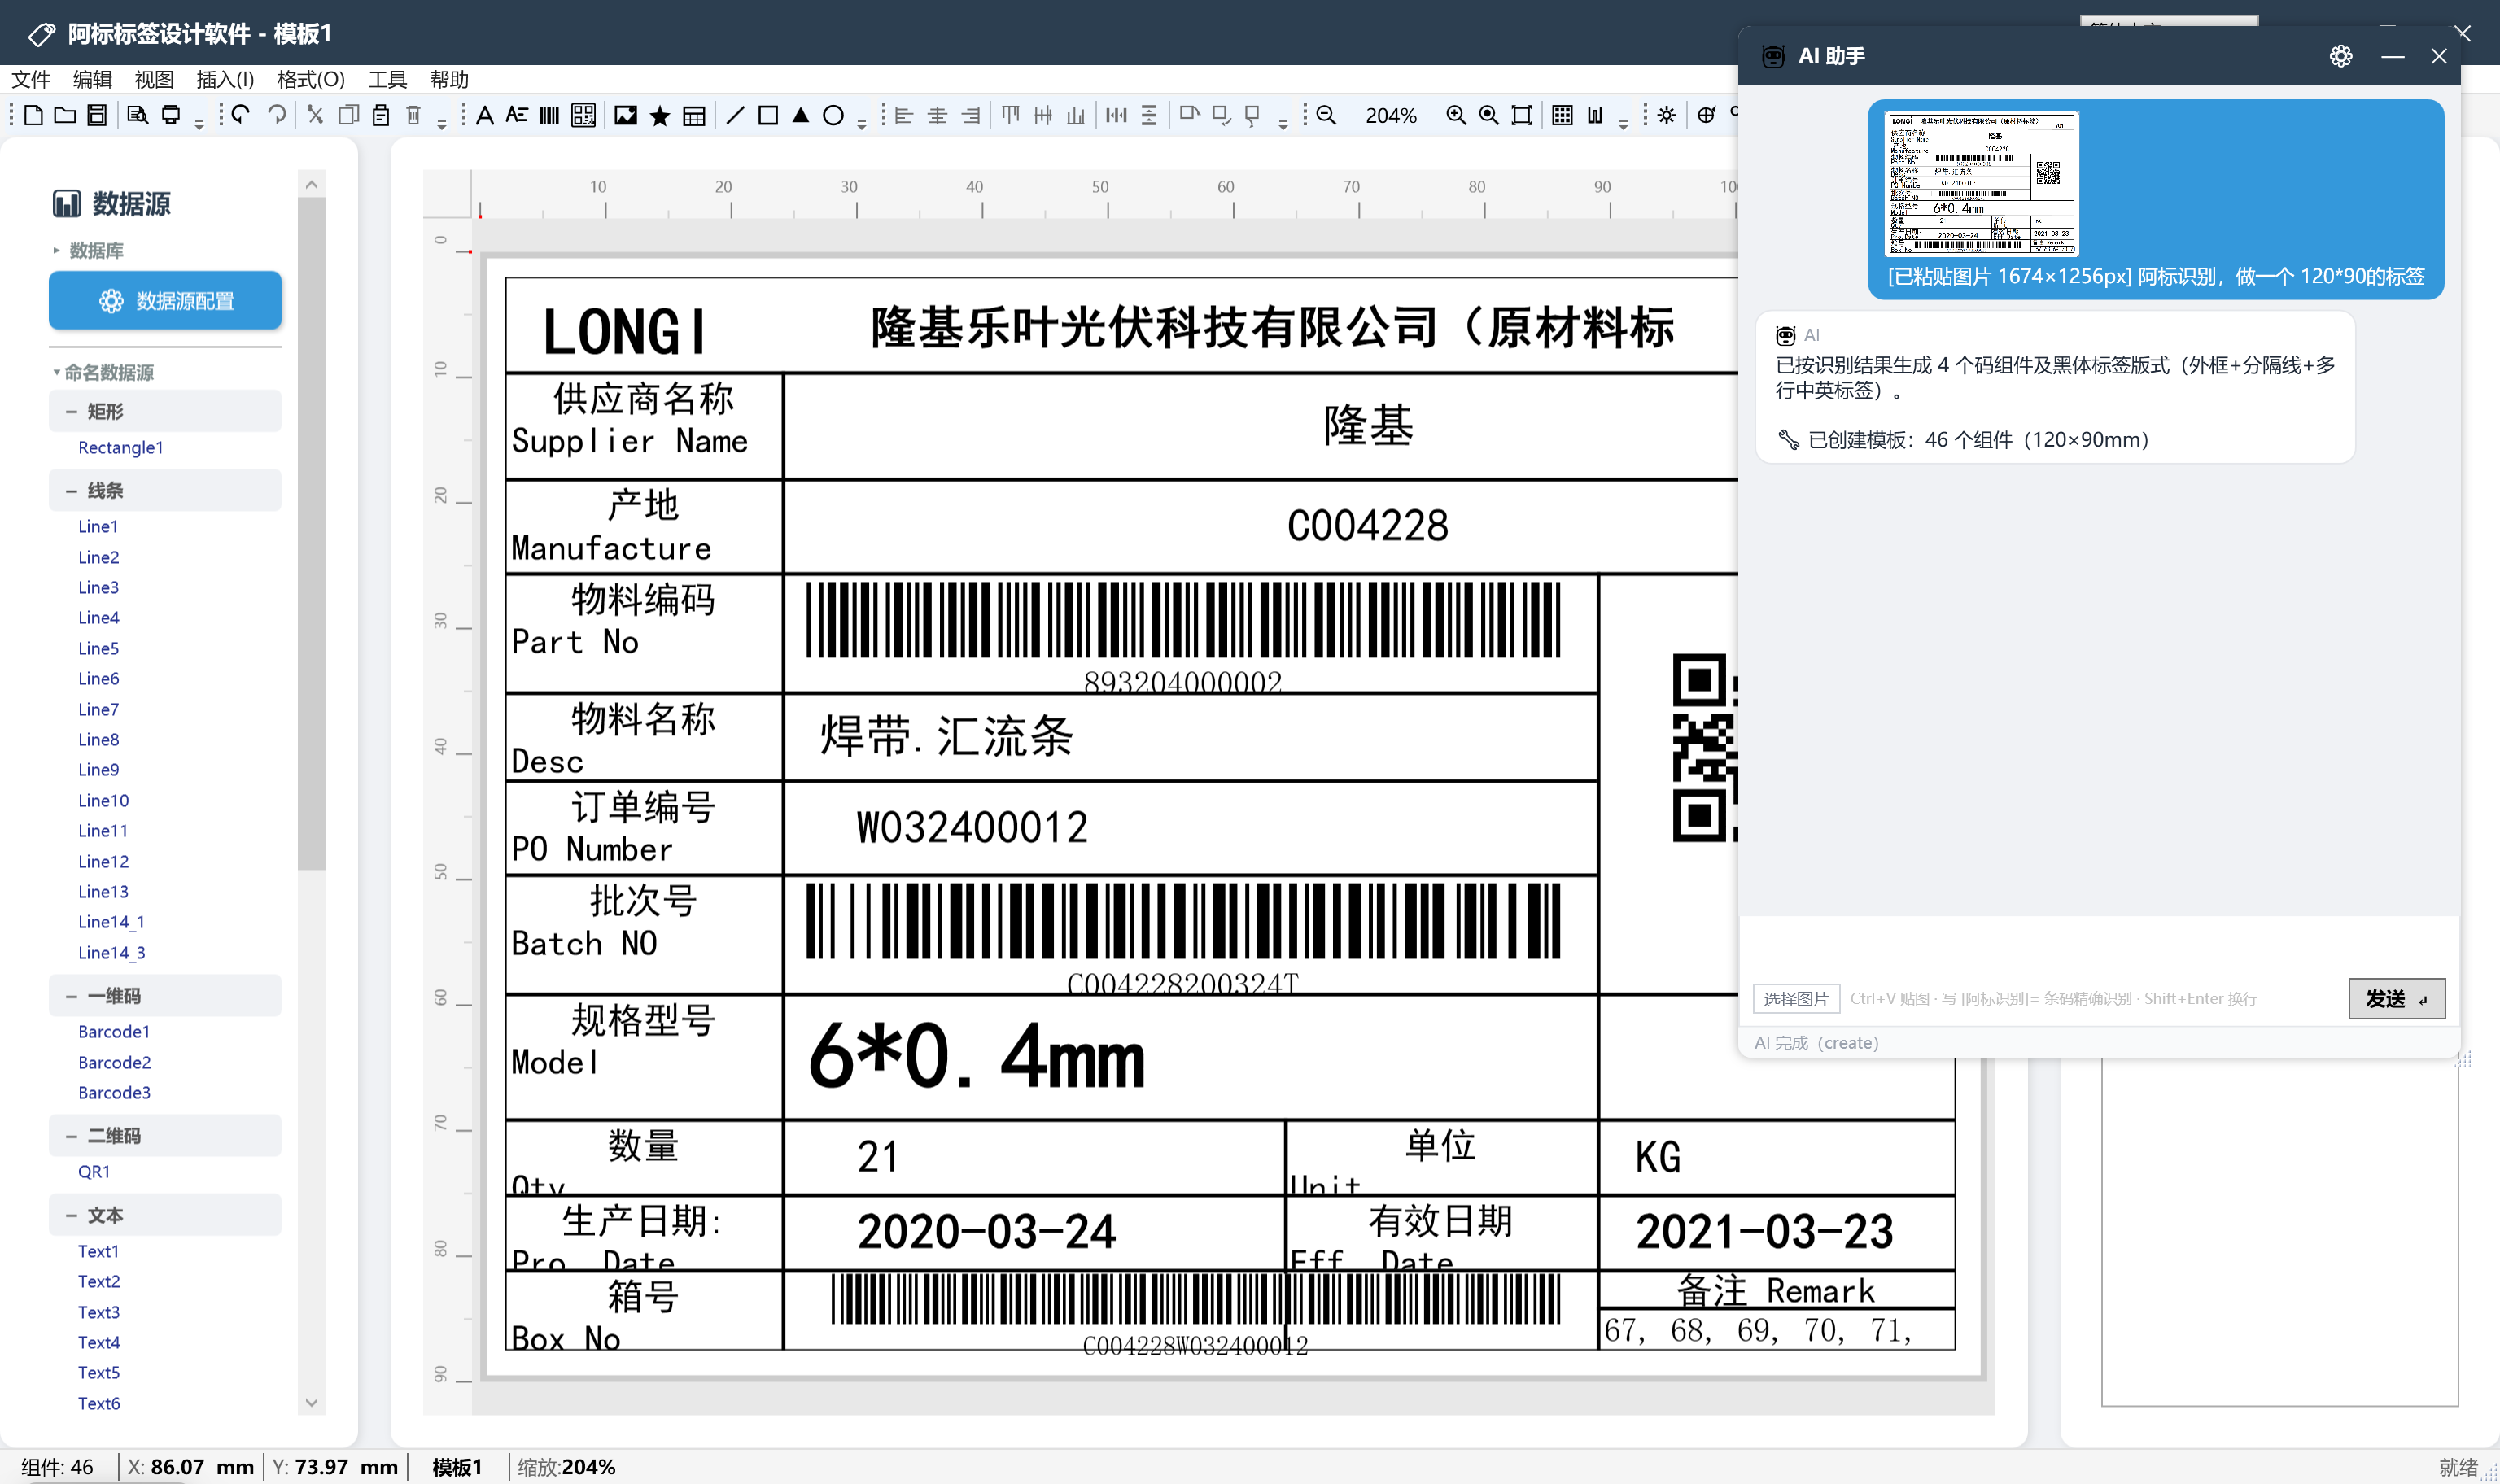
把标签截图丢进对话框。AI 先用视觉模型读出图上的字段(品名、规格、型号、批号、条码内容等),列出清单,再按清单把文本、条码、二维码摆到画布上,生成可直接编辑的模板。不用再逐字段量尺寸、敲内容。
这是"图片转标签"最容易翻车的地方:大模型看图读不出条码的字节内容,猜出来的数字看着像、扫出来是错的。阿标会在把图片交给 AI 之前,先用内置识别器把条码/二维码精确解码,再把真实内容作为提示交给 AI。消息里写「阿标识别」即可。
不用在一堆属性面板里翻找。直接说「把品名调到 14pt 加粗」「这个条码往下挪 2 毫米」「批号改成从数据库 lot_no 取」,AI 直接改模板。每一步都进撤销栈,不满意一键回退。
AI 能看到当前模板接的数据源与可用字段,所以它给出的字段映射是真实存在的列名,不是编的。复杂取数逻辑也能让它写公式或 C#/VB 脚本,写完直接落到组件上。
选「DEEPSEEK网页版」或「小米 MiMo 网页版」通道:用你自己的账号登录一次,不买 API Key、不充值,额度就是你本来有的额度。没有账号的,在登录页免费注册即可。
对数据出网有顾虑?挂本地 Ollama,整条链路都在你的机器或内网里,没有调用费用,也不用担心资料外传。看图排版先 ollama pull 一个视觉模型即可。
配置按厂商分别记住,换厂商不用重填。
不想买 Key、也不想充值就用这条:在自己的账号体系里登录一次,之后直接对话,不额外花钱。登录发生在阿标内置的浏览器窗口里,不会弹出外部浏览器。
注意:这条通道走浏览器网页版,看不了图片;第三方网站改版时可能暂时失效,届时换用 API 通道即可。
要用看图排版就必须走这条(选视觉模型:名字里带 v / vl / vision / omni,如 glm-4.6v-flash、qwen-vl-plus、Qwen3-VL-8B)。各厂商都有免费额度或新人赠券,阿标内置「去哪领免费额度 / Key 在哪」指引,一家一行照着点就行。想省钱可以先挑小号模型试。
需要数据完全不出内网时,挂本地 Ollama 即可。整条链路都在你自己的机器或内网里跑,没有调用费用,也不用担心资料外传。
不用看说明书,装上就能试。
在主界面点 AI 助手按钮,弹出对话框。设置面板里可以随时换厂商、换模型。
零成本就选「DEEPSEEK网页版」,点「登录 / 打开窗口」登录一次;要用看图排版就选 API 厂商并填 Key。内置指引会告诉你各家 Key 在哪领。
把标签截图拖进对话框,或直接说你要做什么。想精确复刻条码,消息里带上「阿标识别」四个字。
差别主要在那些重复又容易出错的环节。